Cloudflare y Googlebot: bloquear crawlers de IA con cabeza

Bloquear crawlers de entrenamiento en Cloudflare puede frenar también a Googlebot. Qué cambia el 15 de septiembre de 2026 y qué revisar en tu CDN.
En breve
- Cloudflare divide el tráfico automatizado en Search, Agent y Training. Si un crawler cae en varias categorías, manda la regla más restrictiva; Googlebot, Applebot y BingBot son los ejemplos que da la propia compañía.
- Marcar Training como bloqueado puede arrastrar a Googlebot, a menos que añadas la excepción correspondiente.
- Search sigue permitido por defecto, así que decir que Googlebot quedará bloqueado en todas partes es una exageración.
- Quién deja pasar a un crawler ya no se decide solo en robots.txt, meta robots o Search Console: la capa CDN/WAF actúa antes de que la petición llegue al origen.
El cambio: quién lo sufre y quién no
Esta edición se escribió el 14 de septiembre de 2026, un día antes de que Cloudflare modificara sus controles para crawlers de IA. El titular cómodo ("Cloudflare bloquea la IA por defecto") despista; lo que afecta al SEO está en la letra pequeña sobre los crawlers de uso mixto.
El 1 de julio de 2026, Cloudflare avisó de que desde el 15 de septiembre los dominios nuevos en su plataforma arrancarían con Training y Agent bloqueados por defecto, siempre en páginas con publicidad. Search se mantiene permitido. Lo mismo se aplica a los clientes Free que ya existían y nunca habían tocado esos ajustes.
Visto así, el efecto en SEO es pequeño y coherente: se separa el rastreo que descubre del rastreo que entrena. El nudo está en los crawlers con varios usos. Cuando uno participa en más de una categoría, Cloudflare le aplica la regla más restrictiva y menciona a Googlebot, Applebot y BingBot como ejemplos de bots que mezclan Search con Training. En consecuencia, un sitio que bloquee Training puede acabar bloqueando a Googlebot. Nadie lo ha deducido desde fuera: está escrito en la documentación de Cloudflare.
Search, Agent y Training: tres usos, a veces un solo bot
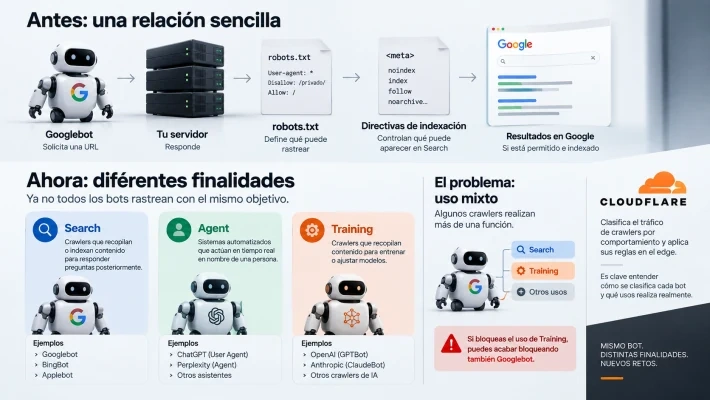
El modelo mental clásico era simple: Googlebot pide una URL, el servidor contesta, robots.txt delimita lo rastreable y las directivas de indexación gobiernan lo que sale en Search. Con la IA, un bot ya no tiene por qué perseguir un único fin: puede indexar, puede recopilar para entrenar o puede entrar en tiempo real por encargo de un usuario. Cloudflare reparte el tráfico según lo que hace cada bot:
| Categoría | Qué hace |
|---|---|
| Search | Recopila o indexa contenido para responder preguntas más adelante. |
| Agent | Sistemas automatizados que actúan en tiempo real en nombre de una persona. |
| Training | Recopila contenido para entrenar o ajustar modelos. |
Si no ves todas las columnas, desliza la tabla horizontalmente.
Los problemas empiezan cuando un único bot figura en dos filas a la vez.
Lo que sí está documentado
Seis puntos se apoyan en documentación oficial de Cloudflare y de Google:
- Los nuevos controles de AI Crawl Control de Cloudflare reparten el tráfico automatizado en Search, Agent y Training.
- Search no se bloquea por defecto. Lo que se restringe, en ciertas configuraciones y páginas, es Training y Agent.
- Cloudflare reconoce que Googlebot, Applebot y BingBot pueden tratarse como multipropósito, y a esos bots se les aplica la regla más estricta.
- Quien elige bloquear Training bloquea también los multipropósito de esa categoría, Googlebot incluido, salvo que configure la excepción.
- Google ofrece Google-Extended como mando aparte: limita ciertos usos del contenido en Gemini y Vertex AI sin afectar a la inclusión en Google Search y sin contar como señal de ranking.
- AI Overviews y AI Mode siguen colgando de Googlebot: según Google, la página tiene que estar indexada y ser elegible en Search, y conviene permitir el rastreo tanto en robots.txt como en la CDN o el hosting.
El nivel donde se decide: red frente a robots.txt
Google-Extended expresa una preferencia sobre el uso del contenido. No es un rastreador HTTP con identidad propia: Google aclara que carece de user-agent de petición, de modo que el rastreo sigue haciéndose con los user-agents habituales y Google-Extended funciona como token de control. Así, Googlebot puede seguir con Search mientras se declara que ciertos usos ligados a Gemini no están autorizados.
Cloudflare trabaja una capa más abajo. Si corta en el edge una petición de Googlebot por considerarlo también Training, esa petición muere antes del origen: ni documento, ni robots.txt que leer después, ni HTML que renderizar. El diagnóstico tiene que empezar antes.
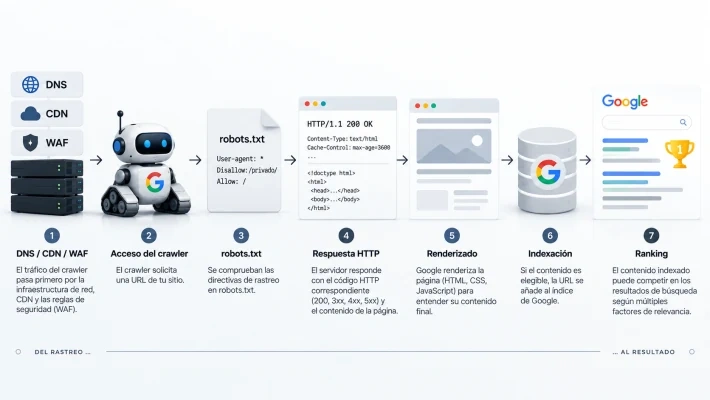
Hemos pasado años entrando en la cadena demasiado tarde, con la vista en robots.txt, canonicals o noindex. Con tantos controles anti-bot, ya no alcanza.
Entre el titular y la letra pequeña
Algunos análisis SEO hablan de "trampa" para Googlebot o de sitios que podrían desaparecer de Google. El fondo es acertado, pero hay que matizar dos cosas.
- "Cloudflare bloqueará Googlebot por defecto." No tal cual. Lo que ocurra depende del dominio, del tipo de cuenta, de si alguien ya cambió los ajustes y, para los nuevos valores por defecto, de que las páginas muestren publicidad. Un sitio de pago que ya existía y no bloqueó Training no debería dar por hecho que dejará de ser rastreado el 15 de septiembre.
- "Bloquear IA equivale a desaparecer de Google." Tampoco. Todo depende de lo que se bloquee: se puede fijar una postura sobre entrenamiento con Google-Extended y dejar intacto el rastreo normal de Googlebot.
Mi lectura es que unas reglas de infraestructura creadas para gestionar la IA pueden tener daños colaterales en SEO cuando el proveedor mete varios usos bajo un solo crawler.
Cómo aplicarlo: auditoría de acceso de crawlers
Así ordenaría el trabajo, con qué mirar en cada paso:
| Paso | Qué revisar |
|---|---|
| 1. Ajustes reales en Cloudflare | AI Crawl Control; los tres bloques Search, Agent y Training; el viejo "Block AI bots"; excepciones para multipropósito; reglas personalizadas de WAF o Bot Management. |
| 2. Comprobar el acceso de Google | Crawl Stats en Search Console; URL Inspection en páginas clave; logs del servidor; Cloudflare Security Events; códigos 403 o 429 sobre crawlers verificados. |
| 3. Confirmar la identidad | Cualquiera puede falsificar un user-agent. Para investigar bloqueos o montar excepciones, recurre a la verificación oficial de Google: rangos IP publicados o reverse DNS. |
| 4. Desacoplar Search de Training | Si buscas visibilidad orgánica con límites al entrenamiento, cortar a Googlebot en el edge es una medida desproporcionada; para eso está Google-Extended. |
| 5. Dejarlo por escrito en SEO | Un retoque de seguridad hecho por IT puede traducirse semanas después en una caída orgánica que se achaque a contenido, indexación o algoritmo. Deporte corporativo clásico: cada equipo rompe lo del otro. |
Si no ves todas las columnas, desliza la tabla horizontalmente.
Ojo con un detalle incómodo: si Cloudflare frena la petición antes del origen, los logs del servidor pueden quedar vacíos. Que Googlebot no aparezca también es información.
Esta era mi secuencia de trabajo en aquel momento, con el 15 de septiembre como fecha de referencia:
- Listar los dominios que pasan por Cloudflare.
- Abrir AI Crawl Control antes del 15 de septiembre.
- Asegurar que Search está permitido.
- Mirar los bloqueos de Training y cómo tratan a los multipropósito.
- Comprobar si el antiguo "Block AI bots" sigue activo.
- Guardar una línea base: Crawl Stats y, si los hay, logs de Googlebot de los siete días anteriores.
- Volver a medir entre el 16 y el 18 de septiembre y comparar.
Si ya hay síntomas de pérdida de indexación, la ruta de diagnóstico está en si Google empezara a desindexar tus páginas, dónde mirarías.
Car rental y travel: el sector donde más pesa
Aquí la relación es directa porque comparadores y webs de viajes combinan tres cosas: mucha URL transaccional, dependencia de un rastreo frecuente y una protección anti-bot en CDN bastante agresiva.
En alquiler de coches, además, los destinos dependen de inventario, precios, aeropuertos, oficinas y combinaciones geográficas que se mueven a menudo. Si Googlebot rastrea mucho menos, la pérdida de rankings puede llegar tarde; antes aparecen otros avisos:
- páginas que tardan más en refrescarse;
- canonicals que se reprocesan más despacio;
- rutas o destinos nuevos que se descubren con menos rapidez;
- cambios de títulos, contenido o enlazado interno que tardan en reflejarse;
- dificultades en arquitecturas programáticas enormes, donde Google debe rastrear millones de combinaciones.
Para un comparador grande montaría una alerta de crawl health, que pregunte algo más que si Google indexa:
- ¿cuántas peticiones verificadas de Googlebot llegan cada día?
- ¿con qué códigos de respuesta?
- ¿qué parte alcanza categorías, destinos y fichas transaccionales?
- ¿se movió ese patrón después de tocar CDN, WAF o bot management?
En sitios grandes, descubrir el primer día que baja el rastreo sale mucho más barato que enterarse tres semanas después por una caída de tráfico.
Cómo lo veo
Más que una noticia puntual, esto es un aviso de arquitectura. Los equipos SEO han mirado la infraestructura anti-bot como asunto de sistemas o seguridad, y ya no se sostiene. Cloudflare, Akamai, Fastly, Imperva o cualquier protección situada delante del servidor pueden alterar el acceso real de los crawlers, y con agentes, bots de búsqueda, de entrenamiento y de uso mixto las reglas se complicarán. Una auditoría técnica debería incluir una revisión expresa de las políticas de bots en CDN y WAF. Validar robots.txt no es suficiente.
Los agentes, además, son una categoría propia; qué ocurre cuando un asistente navega por ti lo vimos en tu cliente busca una vez, Google sigue buscando por él.
Preguntas frecuentes
¿Cloudflare bloquea Googlebot por defecto?
No: Search sigue permitido por defecto. El riesgo surge al bloquear Training, porque Cloudflare aplica la regla más restrictiva a los multipropósito como Googlebot, salvo que configures la excepción.
¿Puedo limitar el entrenamiento de IA sin salir de Google?
Sí, con Google-Extended: limita determinados usos en Gemini y Vertex AI sin afectar a la inclusión en Google Search ni funcionar como señal de ranking. Cortar a Googlebot en el edge para lograrlo es demasiado agresivo.
¿Cómo sé si Cloudflare está frenando a Googlebot?
Revisa Crawl Stats, URL Inspection, Cloudflare Security Events y los 403 o 429 de crawlers verificados. Si el bloqueo se produce antes del origen, los logs del servidor pueden no mostrar nada.
Para acabar el café
El titular real no es que Cloudflare "vaya a bloquear Google". Es que una política pensada para regular cómo los sistemas de IA usan tu contenido puede cerrar el paso al buscador si se aplica en una capa incapaz de distinguir las funciones de un mismo crawler. Google intenta separarlas con Google-Extended y Cloudflare con una clasificación por comportamiento; si ambas taxonomías no coinciden, el coste lo asume el dueño del sitio. De ahora en adelante, auditar el acceso de crawlers incluye robots.txt, CDN, WAF, bot management y logs de edge.
Si quieres que revise cómo llega Googlebot a tu infraestructura, cuéntame tu caso.
Fuentes y lecturas
Cloudflare Blog. "Your site, your rules: new AI traffic options for all customers" - https://blog.cloudflare.com/content-independence-day-ai-options/
Cloudflare Developers. "Block AI Bots" - https://developers.cloudflare.com/bots/additional-configurations/block-ai-bots/
Cloudflare Press Release. "Cloudflare Allows the Agentic Internet to Flourish with a Simple Philosophy: Your Content, Your Rules" - https://www.cloudflare.com/press/press-releases/2026/cloudflare-allows-the-agentic-internet-to-flourish-with-a-simple-philosophy-your-content-your-rules/
Google Search Central. "AI features and your website" - https://developers.google.com/search/docs/appearance/ai-features
Google Crawling Infrastructure. "Google's common crawlers" - https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers
Google Crawling Infrastructure. "Things to Know about Google's Web Crawling" - https://developers.google.com/crawling/docs/about-crawling
Lectura secundaria: Lalit Patel. "Cloudflare's 15 September AI crawler change could block Googlebot. Here's what to check" - https://lalitondigital.com/blog/cloudflare-ai-crawler-change-googlebot/