Presupuesto de rastreo (crawl budget): qué es y cuándo importa

Google visita las páginas de una web para conocer su contenido y detectar cambios. A esas visitas se las llama rastreo. La cantidad de páginas que puede y quiere revisar depende tanto de la respuesta de tu web como del interés de Google por su contenido: eso es el presupuesto de rastreo o crawl budget.
Importa especialmente en sitios grandes, con muchos cambios o con una acumulación relevante de páginas que Google conoce pero todavía no rastrea. En una web pequeña, antes de buscar formas de "aumentarlo", conviene comprobar si existe realmente un problema de rastreo.
Qué es el presupuesto de rastreo de Google o crawl budget
Google no puede dedicar recursos ilimitados a todas las direcciones de internet. Decide qué páginas visitar y con qué frecuencia, dentro de unos límites técnicos y según el interés que encuentra en volver a ellas.
No es una cuota fija de páginas al día ni un botón para conseguir que aparezcan más páginas en los resultados.
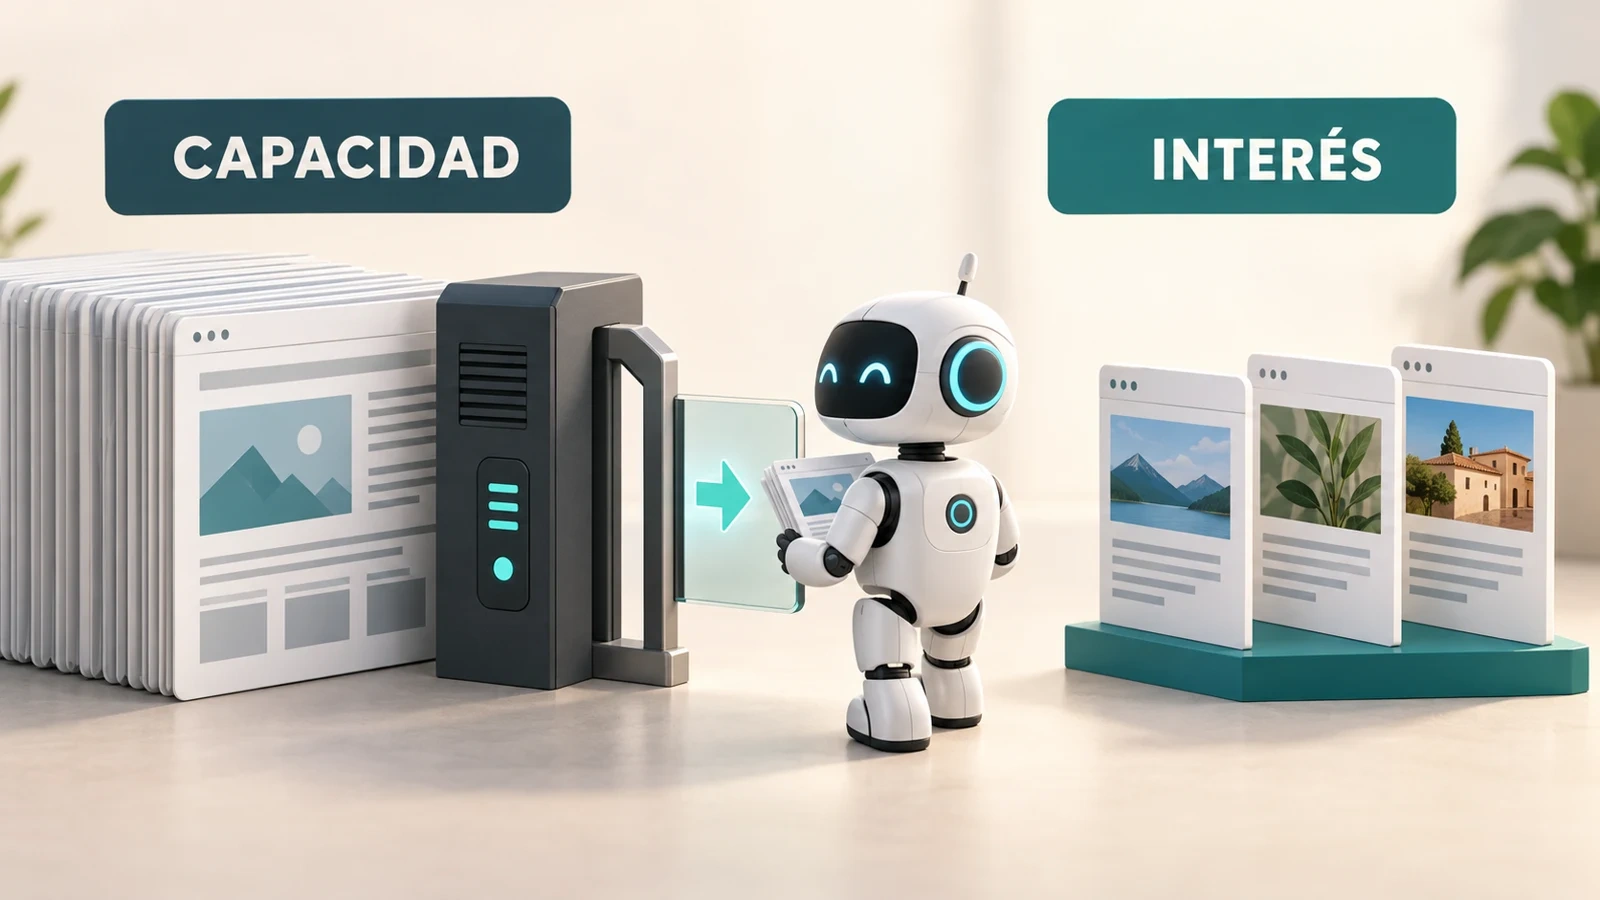
La documentación de Google sobre crawl budget distingue dos componentes: capacidad de rastreo y demanda de rastreo. La primera trata de cuánto puede soportar el servidor. La segunda, de qué contenido considera útil solicitar Google.
La palabra "presupuesto" puede llevar a imaginar una hucha con mil visitas de Googlebot que se gasta cada mañana. Ese modelo resulta engañoso: no hay una cantidad universal que puedas consultar y repartir manualmente entre tus páginas.
Además, Google define aquí el sitio por su nombre de host, es decir, el nombre concreto al que se conecta, como www.ejemplo.com o tienda.ejemplo.com. Un dominio principal y un subdominio pueden tratarse como sitios distintos a efectos del presupuesto de rastreo. No conviene sumar sus datos sin comprobar qué propiedad y qué host estamos mirando.
De qué depende el presupuesto de rastreo de una web
Cuántas páginas puede visitar Google sin sobrecargar tu web
La capacidad de rastreo es el límite técnico de esas visitas. Google intenta rastrear sin desbordar el sitio. Su límite tiene en cuenta las conexiones y el tiempo que permanecen abiertas. Si el servidor responde de forma estable, puede haber margen para ajustar esa capacidad; si se ralentiza o devuelve errores, el rastreo puede reducirse.
La guía actual cita las respuestas 5xx y las señales de limitación como el código 429 entre los factores que pueden disminuir esa capacidad. Antes de pedir más visitas del robot, hay que comprobar que el servidor atiende correctamente las que ya recibe.
Esto no significa que cualquier mejora de velocidad vaya a provocar más rastreo. Puede que la capacidad no sea el freno. El límite y la demanda son cosas diferentes.
Qué páginas quiere revisar Google y con qué frecuencia
La demanda de rastreo es el interés por visitar unas páginas u otras. En Googlebot, el rastreador de Google para la búsqueda, influyen el tamaño del sitio, su frecuencia de actualización, la calidad y relevancia de las páginas y su popularidad. Google también trabaja con el inventario de direcciones que conoce, no solo con las que tú consideras importantes.
Una tienda puede tener un catálogo razonable y, sin embargo, generar muchas URL de filtros y combinaciones. El problema no sería únicamente el número de productos: habría que entender cuántas direcciones distintas se están ofreciendo al rastreador y qué aporta cada una.
Si la demanda es baja, aumentar recursos del servidor no obliga a Google a visitar más páginas. La guía de gestión del presupuesto de rastreo lo dice expresamente: puede rastrear menos aunque no se haya alcanzado el límite de capacidad.
Cuándo necesita tu web una revisión del rastreo de Google
Google orienta su guía avanzada a sitios muy grandes, a sitios medianos o grandes con cambios muy frecuentes y a sitios con una proporción elevada de URL en "Descubierta: actualmente sin indexar".
Como referencias, menciona un millón de páginas con cambios moderados y diez mil o más con cambios diarios muy frecuentes. La propia documentación aclara que son aproximaciones, no umbrales exactos. Tener 9.999 páginas no te da inmunidad ni llegar a diez mil demuestra un problema.
Hay una comprobación más útil: si las páginas importantes se rastrean cuando se publican y los cambios se detectan con normalidad, quizá no exista un cuello de botella que justifique una investigación avanzada.
La ayuda del informe Estadísticas de rastreo señala, además, que los sitios de menos de mil páginas no necesitan controlar el rastreo con ese nivel de detalle. Eso no significa ignorar errores: significa dedicar el tiempo al problema que de verdad aparece, no al que suena más técnico.
Por qué una página visitada por Google puede no aparecer en sus resultados
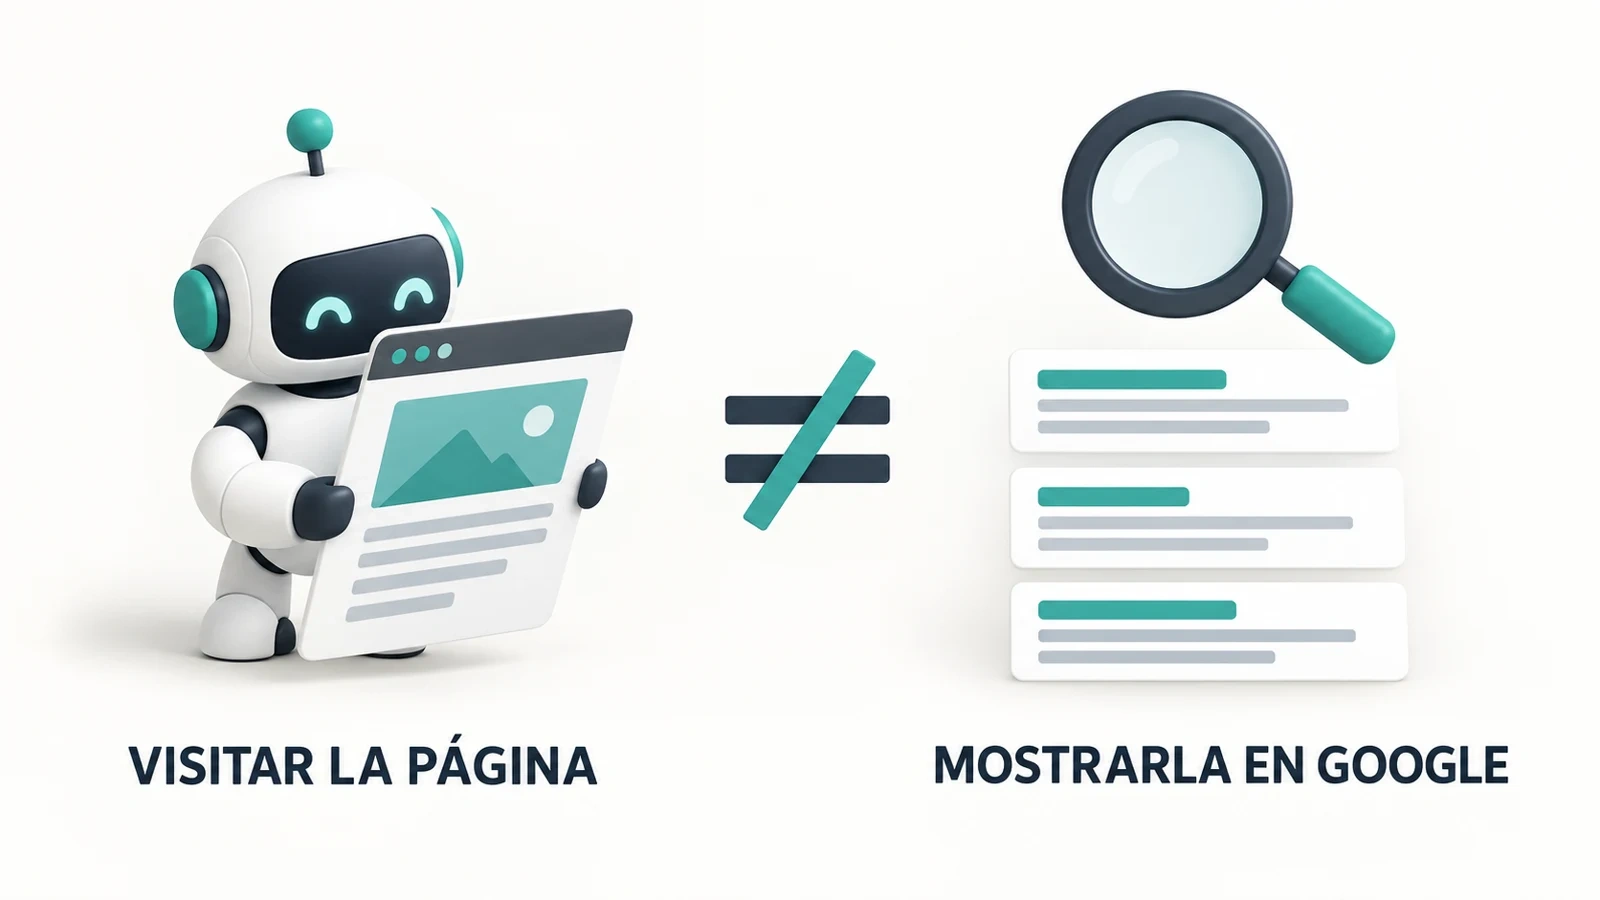
Rastrear es solicitar y procesar el contenido. Indexar es decidir si esa página entra en el índice. Una cosa no garantiza la otra. Tampoco estar indexado garantiza aparecer en una posición determinada.
El informe de indexación de páginas de Search Console separa motivos que no deberían tratarse como si fueran el mismo fallo.
- "Descubierta: actualmente sin indexar" indica que Google conoce la dirección, pero todavía no la ha rastreado.
- "Rastreada: actualmente sin indexar" indica que ya la ha rastreado y no la ha indexado por ahora.
- Una página excluida por una canonical, un noindex o una retirada correcta exige revisar esa situación concreta, no asumir que falta presupuesto.
La diferencia cambia el diagnóstico. Si Google ya ha leído una página, prometer más rastreo como solución automática a su ausencia del índice no responde a la evidencia.
La guía de Search Console desde cero explica dónde encontrar esos motivos. Aquí lo importante es separar las fases antes de decidir qué investigar.
Cómo comprobar en Search Console las visitas de Google a tu web
Cómo comprobar si Google tiene problemas para acceder a tu web
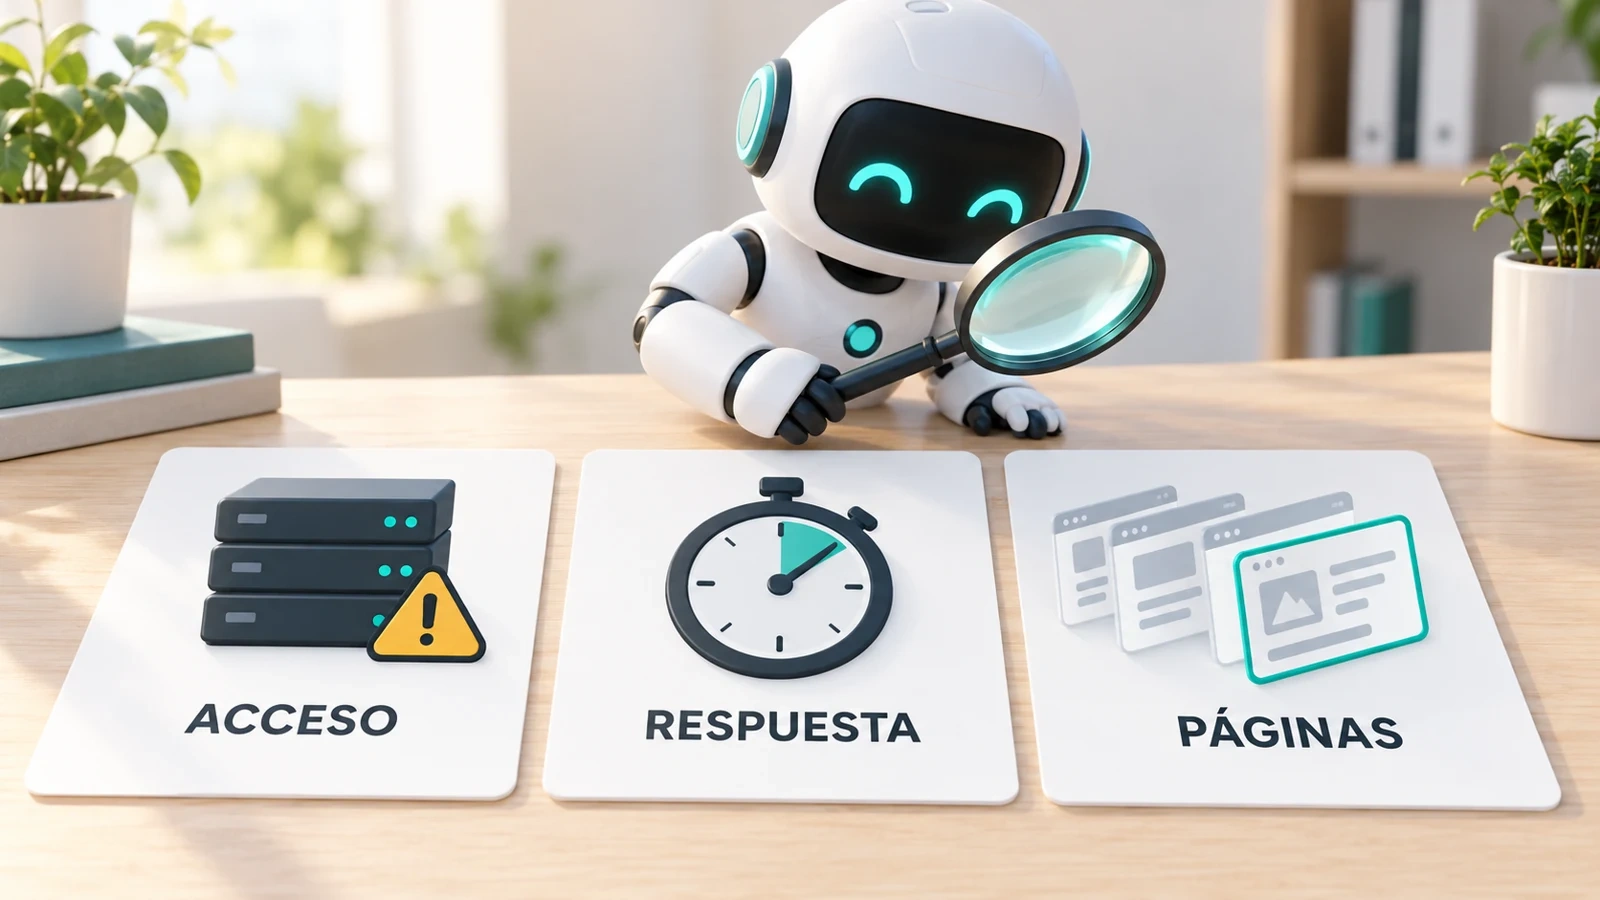
En Search Console, la herramienta de Google que muestra cómo ve tu web, entra en Configuración y abre Estadísticas de rastreo. El informe permite comprobar si Google ha encontrado problemas al acceder al sitio. Cuando hay incidencias, conviene revisar los detalles de disponibilidad de robots.txt, DNS y conectividad, no quedarse con el color del gráfico.
Un fallo temporal ya resuelto no se interpreta igual que un problema recurrente. La fecha importa: compara el momento de las incidencias con los cambios del servidor, las publicaciones y cualquier modificación técnica que pueda haber afectado al acceso.
Cómo comparar las peticiones de Google, los errores y la respuesta de tu web
El informe muestra solicitudes, volumen descargado y tiempo de respuesta, además de agrupaciones por respuesta y tipo de archivo. Son pistas para formular una hipótesis, no un marcador en el que más solicitudes siempre sea mejor.
Si las solicitudes caen mientras aumentan los tiempos y los errores, hay una línea de investigación técnica. Si bajan sin problemas de disponibilidad y el contenido apenas cambia, no puedes concluir lo mismo solo mirando la pendiente.
Por qué las direcciones de ejemplo no muestran todas las visitas de Google
La ayuda de Estadísticas de rastreo aclara que las URL mostradas son una muestra, no todas las solicitudes. Que una dirección no aparezca ahí no demuestra que Google nunca la haya pedido.
Para revisar una página concreta, combina el informe con la inspección de URL. Si necesitas analizar peticiones al servidor con más detalle y tienes acceso a los registros, los logs pueden aportar otra perspectiva.
Cómo detectar direcciones repetidas que Google visita sin necesidad
Un primer paso es comparar las páginas que quieres que Google encuentre con las direcciones que el sitio genera realmente. No son necesariamente la misma lista.
Busca patrones: filtros combinables, ordenaciones, parámetros y versiones repetidas que crean muchas URL con poco contenido distinto. La decisión depende de su función y de si deben aparecer en búsqueda; no consiste en bloquear todos los parámetros por sistema.
Tampoco conviene borrar páginas útiles porque apenas reciben visitas. Antes hay que distinguir una página sin valor de una que está mal conectada. La revisión de páginas huérfanas ayuda a resolver ese problema de descubrimiento y navegación sin confundirlo con capacidad del servidor.
El objetivo es que el inventario tenga sentido. Un rastreo con miles de direcciones repetidas no se arregla necesariamente pidiendo al robot que trabaje más deprisa.
Qué usar para impedir que Google visite una página o la muestre en sus resultados
Para impedir que Google visite determinadas páginas se utiliza el archivo robots.txt. Para pedir que una página no aparezca en los resultados se utiliza la instrucción noindex. Google tiene que poder entrar en la página para leer esa instrucción: impedir la visita y excluir un resultado son decisiones distintas.
La documentación sobre cómo bloquear la indexación con noindex advierte de que bloquear antes la página en robots.txt impide que Google lea la regla. Por eso no deben combinarse mecánicamente para "ahorrar rastreo".
Hay otro matiz importante: la guía de crawl budget desaconseja usar robots.txt como un mecanismo temporal para trasladar recursos de unas páginas a otras. Bloquear cien direcciones no significa que Google vaya a gastar esas cien visitas en las que tú elijas.
Google también explica en sus mitos sobre el rastreo que noindex puede tener efectos indirectos a largo plazo sobre el inventario, pero necesita rastreo para ser detectado. Su función principal sigue siendo controlar la indexación, no actuar como un regulador inmediato de peticiones.
Cómo elegir una corrección y comprobar si mejora el rastreo de Google
Antes de tocar reglas, deja por escrito la hipótesis. "Google no llega a las fichas nuevas y el servidor devuelve errores" es una pregunta investigable. "Tenemos poco crawl budget" es una etiqueta demasiado amplia para decidir cambios.
Después define qué tendría que mejorar: disponibilidad, tiempos de respuesta o acceso a determinadas familias de URL. Comprueba también que las páginas importantes sigan accesibles y que no hayas eliminado su descubrimiento al reducir el inventario.
La solicitud de un nuevo rastreo tampoco ofrece una solución ilimitada: Google indica que repetir solicitudes para la misma URL no acelera el proceso y que pedir un rastreo no garantiza la inclusión en resultados.
En una auditoría SEO, esta investigación sirve para decidir dónde actuar: servidor, generación de URL, descubrimiento o valoración del contenido. Cada diagnóstico pide una intervención distinta. Un aumento de solicitudes sin mejora en las páginas importantes no sería, por sí solo, el resultado que buscamos.
Para acabar el café
El crawl budget depende de lo que Google puede rastrear y de lo que quiere rastrear. Antes de intentar aumentarlo, comprueba si las páginas importantes se quedan sin visitar, si el servidor tiene problemas y si el inventario está lleno de direcciones que no aportan contenido distinto.
Más rastreo no equivale automáticamente a más indexación. La buena decisión empieza separando esas dos cosas.