Robots.txt no es un candado: bloquear una URL no la saca de Google

Alguien bloquea una página en robots.txt porque no quiere que salga en Google. Pasan las semanas y la página sigue saliendo. Sin descripción, con un título raro, pero sale.
No es un fallo de Google. Es exactamente lo que dice su documentación, y casi nadie la lee antes de tocar el archivo.
Robots.txt y sitemap.xml se mencionan siempre juntos y se confunden a todas horas. Uno habla de a dónde puede entrar un rastreador. El otro, de qué páginas te gustaría que mirase. Ninguno de los dos decide qué aparece en los resultados. Vamos por partes.
Robots.txt decide a dónde entra el rastreador, no qué aparece en Google
Un archivo robots.txt le dice a los rastreadores qué URLs pueden visitar. Según la introducción de Google a robots.txt, sirve sobre todo para no saturar tu servidor con peticiones, y no es un mecanismo para mantener una página fuera de Google.
La razón es que rastrear e indexar son dos cosas distintas. La misma página de Google lo explica: si bloqueas una URL pero otras webs la enlazan con un texto descriptivo, Google puede indexar la dirección sin haberla visitado. Aparece en los resultados, pero sin descripción, porque no pudo leer nada de ella.
Para sacar una página de los resultados, Google propone otras vías: la etiqueta noindex, proteger la página con contraseña o eliminarla. Lo detalla en su guía para bloquear la indexación con noindex, donde añade dos matices que importan:
- Noindex se puede poner como etiqueta meta en el HTML o como cabecera HTTP (X-Robots-Tag). Escribir noindex dentro del propio robots.txt no lo admite Google.
- Para ver la etiqueta, Google tiene que poder rastrear la página. Si robots.txt le cierra la puerta, el noindex es invisible.
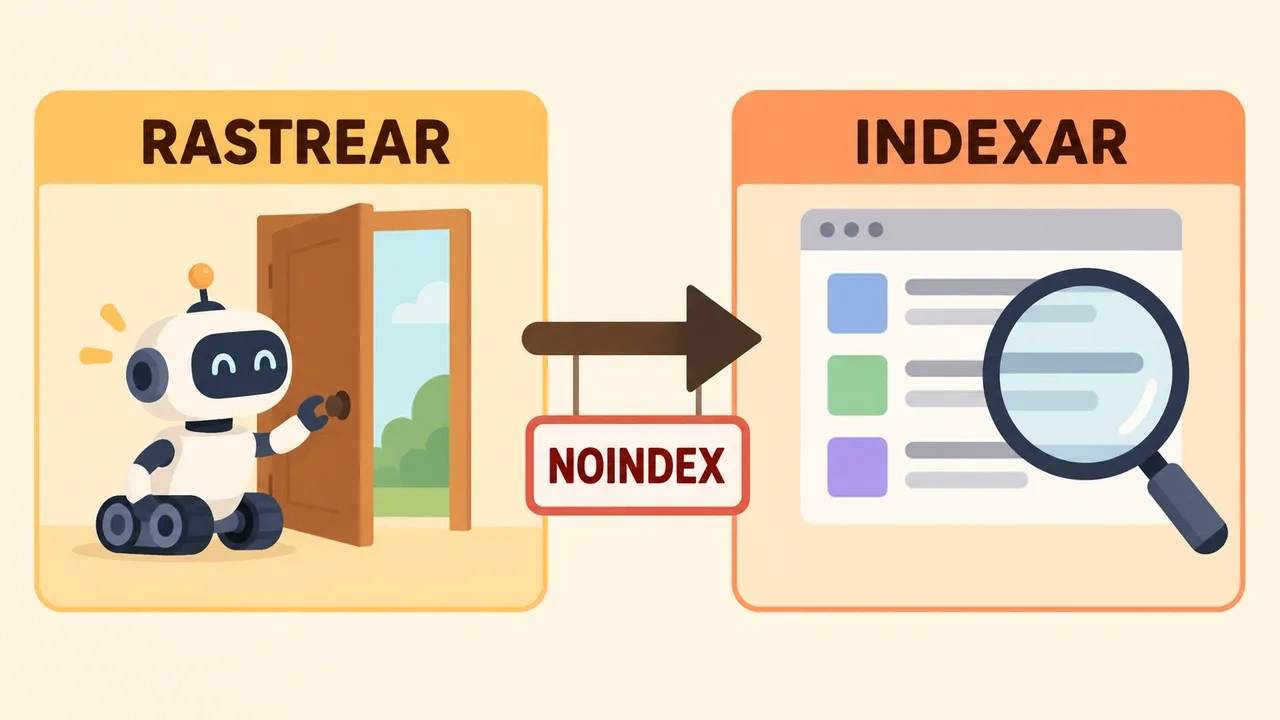
Ahí está el error más típico: poner noindex en una página y bloquearla además en robots.txt. Las dos instrucciones se anulan. La página que querías esconder sigue a la vista, y tú piensas que no funciona.
Si ya cometiste el error, el arreglo es quitar el bloqueo de robots.txt para que Google vuelva a entrar y lea el noindex. Para comprobar cómo está una página, Google recomienda la herramienta de inspección de URLs y el informe de indexación de páginas de Search Console. Conviene tener paciencia: la propia guía avisa de que volver a rastrear puede tardar meses en páginas poco visitadas.
Reglas de funcionamiento que se olvidan
La página de Google que explica cómo interpreta el archivo robots.txt tiene varios detalles que ahorran disgustos:
- El archivo debe estar en la raíz del sitio, y distingue mayúsculas de minúsculas. Un robots.txt dentro de una subcarpeta no vale.
- Solo vale para el protocolo, dominio y puerto donde vive. Un subdominio necesita el suyo.
- Si el servidor responde con un error 4xx (salvo el 429), Google actúa como si el archivo no existiera, y rastrea sin restricciones.
- Si responde con un 5xx, Google deja de rastrear el sitio durante las primeras 12 horas. Después usa la última copia buena durante un máximo de 30 días.
- Google guarda el archivo en caché hasta 24 horas, así que un cambio no se aplica al instante.
- Solo lee los primeros 500 KiB. Lo que pase de ahí se ignora.
- Si hay varios grupos de reglas, a cada rastreador le aplica solo uno: el del agente de usuario más específico. El orden de los grupos da igual.
Un consejo práctico que sale de su guía para crear el archivo: edítalo con un editor de texto plano, no con un procesador de textos, porque las comillas tipográficas y otros caracteres especiales pueden romper las reglas.
Sitemap.xml no manda en Google, sugiere
El sitemap es un archivo donde listas las páginas, vídeos y otros ficheros que consideras importantes. Google lo lee para rastrear mejor tu sitio y para recibir datos como la fecha de última modificación. Así lo describe su introducción a los sitemaps.
Esa misma página dice algo que contradice mucha costumbre: puede que no lo necesites. Si tu sitio tiene unas 500 páginas o menos, está bien enlazado desde la home y no depende de vídeo, imágenes o noticias, el sitemap no es imprescindible. Sí ayuda en sitios grandes, nuevos con pocos enlaces externos, o con mucho contenido multimedia.
Cuando decides tenerlo, Google pide unas condiciones concretas en su guía para crear un sitemap:
- Archivo en UTF-8.
- URLs absolutas y completas, con protocolo y dominio. Las rutas relativas no sirven.
- Un máximo de 50 MB sin comprimir o 50.000 URLs por archivo. Si te pasas, divides en varios y los agrupas en un índice de sitemaps.
- Mejor en la raíz del sitio, porque un sitemap que cuelga de una carpeta solo afecta a esa carpeta.
Hay un malentendido muy extendido con Search Console. Según su informe de sitemaps, enviar un sitemap solo le dice a Google dónde está el archivo. No es una subida, y no obliga a Google a indexar nada. Además, el sitemap tiene que ser accesible para Googlebot, y puedes verificarlo con una inspección de la URL en vivo. Lo contrario también engaña: borrar un sitemap del informe no hace que Google olvide las URLs que ya conocía. Para que deje de rastrearlo hay que poner una regla en robots.txt, borrar el archivo o usar noindex (en este caso como cabecera de respuesta).
Lo que se rompe cuando los dos se contradicen
Si una URL está en el sitemap y bloqueada en robots.txt, le estás diciendo a Google "mira esta página, es importante" y "no entres" en el mismo minuto. El sitemap debería contener solo las URLs que quieres que se rastreen y se indexen. Todo lo demás sobra.
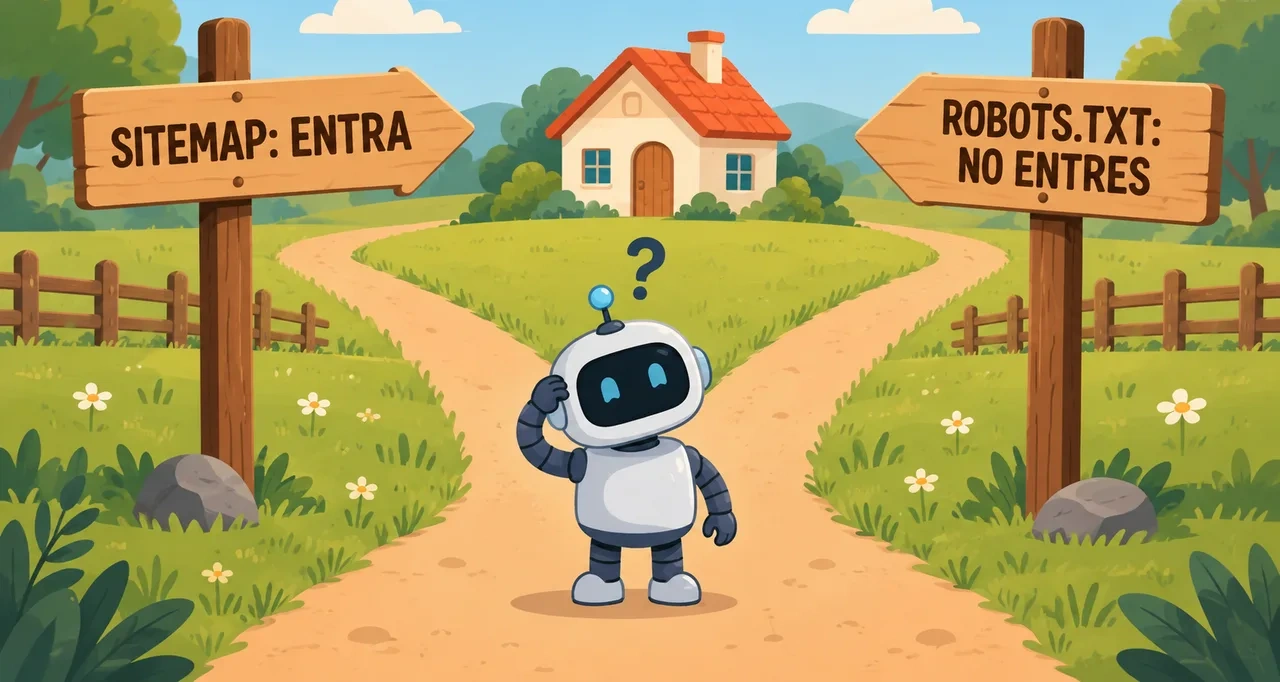
Con las páginas que quieres fuera, la regla es la contraria: fuera del sitemap, y la forma de sacarlas de Google es noindex, no robots.txt.
Un ejemplo de este mismo sitio: la política de cookies no aporta nada en los resultados de búsqueda. Está marcada con noindex y nofollow, no aparece en el sitemap y no está bloqueada en robots.txt, precisamente para que Google pueda entrar a leer el noindex. Tres piezas coherentes entre sí, en vez de dos que se pisan.
Si quieres ver por qué esto importa más allá de las cookies, piensa en una web con miles de URLs generadas por filtros o buscadores internos. Ahí el equilibrio entre qué se rastrea, qué se indexa y qué se ofrece en el sitemap deja de ser un detalle. Ya lo tocamos en la arquitectura transaccional, donde cada URL tiene que ganarse su sitio.
Cómo conectarlos: una línea
Robots.txt admite una línea Sitemap con la dirección completa del archivo. Puedes poner varias. Es opcional, no depende de ningún rastreador concreto, y sirve para que cualquiera que lea tu robots.txt encuentre tu sitemap sin que hagas nada más.
User-agent: *
Disallow: /carrito/

Sitemap: https://tudominio.com/sitemap.xml
La dirección tiene que ir completa, con https y dominio. Una ruta relativa no funciona.
Checklist de diez minutos
- Abre tudominio.com/robots.txt. ¿Existe y carga? ¿Hay un "Disallow: /" que alguien dejó de una fase de pruebas?
- Comprueba que no bloqueas scripts, estilos o imágenes que la página necesita para entenderse. Si faltan, Google no analizará bien las páginas que dependen de ellos.
- Abre tu sitemap. Que solo tenga URLs que existen, responden con 200 y quieres indexar. Sin redirecciones, sin noindex, sin páginas bloqueadas.
- Confirma que robots.txt apunta al sitemap con su URL completa.
- En Search Console, envía el sitemap y mira el informe de páginas: te dirá cuáles Google ha descubierto, cuáles no y por qué.
- Para cualquier página que quieras sacar de Google: noindex, no Disallow. Comprueba además con la inspección de URLs que Google puede entrar a leerlo.
La idea para quedarte
Robots.txt controla el acceso. Noindex controla la aparición. El sitemap propone. Mezclarlos es lo que hace que una página que querías esconder siga a la vista, o que una importante tarde semanas en aparecer.
Abre hoy tu robots.txt. Si tienes un Disallow con una página que quieres fuera de Google, ya sabes qué hay que cambiar.